Attention Is All You Need
你问它一个问题,它一个字一个字往外蹦。蹦到第二十个字,好像已经忘了你前面说过什么。
这不是它记性差。它读你这句话的方式,本来就跟人不一样:先切成块,再算每一块跟其他块的关系。
这篇导读讲的,就是那篇把「循环」拆掉的论文。
2017 年 6 月 12 日,一篇八页的论文挂上 arXiv。作者八个人,脚注写明贡献相同、署名顺序随机。标题五个词:《Attention Is All You Need》。
九年过去,几乎所有能和你对话的模型,骨子里还是这篇论文的结构。它没有发明新的数学——注意力机制三年前就有了;它做的是把当时没人敢拆的东西拆掉:序列模型的主干,循环。
这篇导读按论文自己的顺序走。每一节先给英文原句和中文对照,再解释它在讲什么、为什么这么设计、代价在哪里。论文里的四张图全部收入,另附四段可以当场播的视频。篇幅很长,右栏有目录,可以直接跳。
在这之前,机器翻译靠什么
2014 到 2016 年,神经机器翻译的主流是编码器—解码器结构。编码器把一句德语读成一串隐藏状态,解码器再一个词一个词地吐出英语。两头都是循环网络,具体说多是 LSTM 或 GRU。
这个结构有一个绕不开的性质:它必须按顺序算。第 t 个位置要等第 t−1 个位置算完,因为后者的输出是前者的输入。论文引言第二段把这件事说得很直白:
Recurrent models typically factor computation along the symbol positions of the input and output sequences. Aligning the positions to steps in computation time, they generate a sequence of hidden states ht, as a function of the previous hidden state ht−1 and the input for position t. This inherently sequential nature precludes parallelization within training examples, which becomes critical at longer sequence lengths, as memory constraints limit batching across examples.
Vaswani et al., §1
循环模型沿输入与输出序列的符号位置分解计算。把位置对齐到计算的时间步,它们生成一串隐藏状态 ht,它是前一个隐藏状态 ht−1 与位置 t 的输入的函数。这种与生俱来的顺序性使得训练样本内部无法并行,而序列一长这就成了关键问题,因为显存限制会约束跨样本的批处理。
两个后果。第一,GPU 有几千个核心,但训练时只能一步一步走,绝大部分时间在等。第二,两个相隔很远的词之间,信息要走很多步才能碰头——步数随距离线性增长,越远越难学。
2016 年前后有三条路试图绕开这件事。ByteNet 用膨胀卷积,把两个位置之间的路径从线性压到对数;ConvS2S 用堆叠的卷积层,路径仍然线性增长,但每一步可以并行;还有一条路是把注意力加进来。
注意力那时已经存在。Bahdanau 在 2014 年提出,让解码器在生成每个词时,去看编码器所有位置的隐藏状态,算一组权重再加权求和。这解决了长句里「对齐」的问题——德语动词跑到句末,英语动词在前面,模型能自己找到对应关系。但注意力的角色是配件:主干还是循环,顺序性一点没动。
论文要做的,是把配件换到主干的位置,然后看看主干还能不能立住。
In these models, the number of operations required to relate signals from two arbitrary input or output positions grows in the distance between positions, linearly for ConvS2S and logarithmically for ByteNet. This makes it more difficult to learn dependencies between distant positions. In the Transformer this is reduced to a constant number of operations, albeit at the cost of reduced effective resolution due to averaging attention-weighted positions, an effect we counteract with Multi-Head Attention.
Vaswani et al., §2
在这些模型里,把任意两个输入或输出位置上的信号关联起来所需的操作数,随位置间距离增长:ConvS2S 是线性,ByteNet 是对数。这让学习远距离依赖更难。在 Transformer 里这被降到常数个操作,代价是注意力加权位置的平均带来了有效分辨率的下降,这个副作用我们用多头注意力来抵消。
最后半句值得留意。作者自己承认自注意力有一个副作用:把很多位置的信息平均到一起,等于把分辨率磨平了。他们给的解药不是改公式,而是多开几组——这就是后面第五节的多头。
论文的主张
摘要不长,一共六句,是全篇最浓缩的地方。全文抄在下面。
The dominant sequence transduction models are based on complex recurrent or convolutional neural networks that include an encoder and a decoder. The best performing models also connect the encoder and decoder through an attention mechanism. We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely. Experiments on two machine translation tasks show these models to be superior in quality while being more parallelizable and requiring significantly less time to train. Our model achieves 28.4 BLEU on the WMT 2014 English-to-German translation task, improving over the existing best results, including ensembles, by over 2 BLEU. On the WMT 2014 English-to-French translation task, our model establishes a new single-model state-of-the-art BLEU score of 41.8 after training for 3.5 days on eight GPUs, a small fraction of the training costs of the best models from the literature.
Vaswani et al., Abstract
主流的序列转换模型基于包含编码器与解码器的复杂循环或卷积神经网络。表现最好的模型还会用注意力机制连接编码器与解码器。我们提出一种新的简单网络结构 Transformer,它完全基于注意力机制,彻底抛弃了循环与卷积。在两个机器翻译任务上的实验表明,这些模型在质量上更优,同时更可并行,训练所需时间显著更少。我们的模型在 WMT 2014 英德翻译任务上取得 28.4 BLEU,比此前最好结果(含集成)高出 2 BLEU 以上。在 WMT 2014 英法任务上,模型在八块 GPU 上训练 3.5 天后,创下 41.8 的单模型最好成绩,只占文献中最优模型训练成本的一小部分。
三个断言:质量更好、更可并行、训练更省。后面第十、十一节用数字兑现这三个断言。
摘要里那句“based solely on attention mechanisms”是全文最容易读歪的一句。它说的是不需要循环和卷积,不是「只需要注意力」。图 1 里除了注意力,还有前馈网络、残差连接、层归一化、位置编码,一样都不能少。这一点后面第九节和第十七节还会回到。

把架构图拆开:编码器与解码器
这张图信息密度很高,值得一格一格看。从最底下往上。
最下面是两行输入:左边是源语言句子,右边是已经生成的目标语言前缀,标着 shifted right(右移一位)。为什么要右移,第四节末尾会讲。输入先过嵌入层(Input / Output Embedding),变成 512 维向量,再和位置编码相加——注意是相加,不是拼接,所以位置编码也必须是 512 维,这是论文特意说明的一点。
往上是灰色的大方框,旁边标着 N×,表示这个结构重复 N 层。编码器和解码器都是 N=6。
编码器每层里有两个子层,论文第 3.1 节的原话是:
The encoder is composed of a stack of N = 6 identical layers. Each layer has two sub-layers. The first is a multi-head self-attention mechanism, and the second is a simple, position-wise fully connected feed-forward network. We employ a residual connection around each of the two sub-layers, followed by layer normalization. That is, the output of each sub-layer is LayerNorm(x + Sublayer(x)), where Sublayer(x) is the function implemented by the sub-layer itself.
Vaswani et al., §3.1
编码器由 N=6 个相同层堆叠而成。每层有两个子层。第一个是多头自注意力机制,第二个是简单的逐位置全连接前馈网络。我们在两个子层周围各加一条残差连接,随后做层归一化。也就是说,每个子层的输出是 LayerNorm(x + Sublayer(x)),其中 Sublayer(x) 是该子层自身实现的函数。
三个细节藏在这句话里。第一,“identical”——六层结构完全一样,不共享参数,只是形状相同。第二,“position-wise”——前馈网络对每个位置独立施加同一组参数,位置之间不交流,所以它在图上是一小块而不是一条贯通的线。第三,“LayerNorm(x + Sublayer(x))”——归一化在残差相加之后,这个顺序后来被称为 Post-LN,第九年之后回头看,它是这篇论文里被改得最彻底的一处(第十六节)。
解码器多一个子层,论文接着写:除了两个相同的子层,解码器插入第三个子层,对编码器的输出做多头注意力。它的 Q 来自解码器自己,K 和 V 来自编码器输出——这是编码器与解码器之间唯一的信息通道。整个方框里,只有这一处箭头从左边穿到右边。
解码器的自注意力还要加掩码。原因很直接:训练时右移一位的目标句是整句喂进去的,如果不遮住后面,模型在预测第 3 个词时已经看到第 4 个词,等于抄答案。实现方式是把未来位置的注意力分数加上负无穷,softmax 之后这些位置的权重恰好是零,不参与加权求和。这比「把矩阵上三角置零再重归一化」省事,也不破坏矩阵形状。
最上面是 Linear 加 Softmax:把 512 维的隐状态投到词表大小,再做归一化,得到下一个词的概率分布。
还有一处容易漏:三个地方的权重是共享的——两层嵌入和 softmax 之前那个线性层共用同一个矩阵,而且嵌入层要乘上 √d_model。乘法是为了让嵌入的数值尺度和加上去的位置编码相当,不然 512 维相加时一边会被另一边压过去。这个技巧后来所有模型都照抄。
缩放点积注意力
第 3.2 节先给定义,一句话说完:
We call our particular attention “Scaled Dot-Product Attention”. The input consists of queries and keys of dimension dk, and values of dimension dv. We compute the dot products of the query with all keys, divide each by √dk, and apply a softmax function to obtain the weights on the values.
Vaswani et al., §3.2.1
我们称这种注意力为「缩放点积注意力」。输入由维度为 dk 的查询与键、维度为 dv 的值构成。我们计算查询与所有键的点积,各自除以 √dk,再施加 softmax 函数,得到施加在值上的权重。
写成公式是:
Attention(Q, K, V) = softmax(QKᵀ / √d_k) · V三个矩阵 Q、K、V 从同一份输入 X 线性变换而来:
Q = X W^Q, K = X W^K, V = X W^VW^Q、W^K、W^V 是可训练参数,形状都是 d_model × d_k(或 d_model × d_v)。base 模型里 d_model=512,d_k=d_v=64。
怎么理解这三个东西。Q 是「我在找什么」,K 是「我这儿有什么」,V 是「如果被选中,我交出什么」。Q 和 K 做点积,得到一个相关性分数;分数过 softmax 变成总和为 1 的权重;再用权重把 V 加权平均。整个过程是可微的,权重不是硬选择而是软混合,所以能反向传播。
这里有个常被忽略的地方:Q、K、V 不是同一个东西的三种叫法,而是三组不同的投影。正因为投影矩阵不同,「我在找什么」和「我有什么」才可能错开,注意力才有意义。如果三者用同一个矩阵,Q·Kᵀ 就退化成 X Xᵀ,只能衡量向量的自身相似度。
附:为什么要除以 √d_k
论文里只用了一个脚注讲这件事,但它是全文最漂亮的一处推导。
假设 q 和 k 的每个分量都是独立的随机变量,均值 0、方差 1。那么点积 q·k = Σ q_i k_i 的均值仍是 0,方差是 d_k——因为每一项 q_i k_i 的方差是 1×1=1,而独立变量求和时方差相加。
也就是说,d_k 越大,点积的绝对值越容易变得很大。softmax 的输入一大,分布就接近 one-hot,输出几乎全压在最大值那一项上;而在这种区域,softmax 的梯度趋近于零。梯度没了,训练就停了。
除以 √d_k 把方差拉回 1:Var(q·k / √d_k) = d_k / d_k = 1。输入回到 softmax 的敏感区间,梯度不至于消失。
论文原文只有一句:We suspect that for large values of dk, the dot products grow large in magnitude, pushing the softmax function into regions where it has extremely small gradients. 但脚注把证明给全了。这也是为什么 d_k 取 64 而不是 512——头小一点,方差压力小一点。
为什么用点积而不是加性注意力(Bahdanau 那种,用一个小网络算分数)?论文给了两条理由,一条理论一条工程。理论上,d_k 小的时候两者表现差不多,d_k 大时不做缩放的点积反而不如加性注意力——这正是上面那个方差问题的另一面。工程上,点积可以写成矩阵乘法,而矩阵乘法是 GPU 上被优化得最深的一类运算,加性注意力做不到。
两条路线的对比(论文 §3.2.1 原话):
dot-product attention  — 更快、更省内存,因为可用高度优化的矩阵乘法实现
additive attention     — d_k 大时不必缩放,但慢、费内存
图 2 左边是缩放点积注意力的数据流,从上到下读就是公式本身:Q 和 K 先 MatMul,Scale 除 √d_k,可选 Mask,SoftMax 归一化,最后再和 V 做一次 MatMul。

多头注意力
单个注意力头做一件事:算一组权重,做一次加权平均。问题在于加权平均是「抹平」的运算——它把多个位置的信息压成一个向量,位置之间的差异被平均掉了。前面第二节引过作者自己的话:代价是有效分辨率下降。
多头的做法是并行开多组,每组用不同的投影矩阵,各算各的,最后拼起来再投一次。
Instead of performing a single attention function with d_model-dimensional keys, values and queries, we found it beneficial to linearly project the queries, keys and values h times with different, learned linear projections to dk, dk and dv dimensions, respectively. ... Multi-head attention allows the model to jointly attend to information from different representation subspaces at different positions. With a single attention head, averaging inhibits this.
Vaswani et al., §3.2.2
与其用 d_model 维的键、值、查询做单次注意力,我们发现把查询、键、值用 h 组不同的、可学习的线性投影分别投到 dk、dk、dv 维,是有益的。……多头注意力让模型能同时关注不同位置上、不同表示子空间里的信息。只有单个注意力头时,平均会抑制这一点。
公式三行:
MultiHead(Q, K, V) = Concat(head_1, …, head_h) · W^O
head_i             = Attention(Q W_i^Q,  K W_i^K,  V W_i^V)
base 模型 h=8,每个头 d_k=d_v=64。8×64=512=d_model,所以拼接之后维度正好回到 512,再乘 W^O(512×512)投一次。
关键在算账:多头不是把计算量乘了 8。单头是全维 512 维算一次,多头是 8 个 64 维各算一次;注意力的计算量正比于 d_k²(投影)和 n²·d_k(相似度),8×(n²×64) 与 1×(n²×512) 同量级。所以论文说「总计算成本与全维度的单头注意力相近」。多头买到的是并行的多个视角,不是更多的算力。

不同头到底学什么,论文在附录里给了可视化(第十四节的三张图)。概要地说:有的头盯着相邻词,有的头追长距离依赖,有的头专门解决代词指代。这种分工不是设计出来的,是训练自己长出来的。
三处用武之地
第 3.2.3 节讲多头注意力在这个架构里出现在三个位置,区别只在 Q、K、V 的来源。
编码器自注意力。 Q、K、V 全部来自上一层编码器输出。每个位置和同一句里所有位置(包括自己)算相关性。这一层是双向的,没有掩码。
解码器掩码自注意力。 Q、K、V 全部来自上一层解码器输出,但加了掩码:位置 i 只能看到 ≤ i 的位置。这一层负责让已生成的词互相参照。
编码器—解码器交叉注意力。 Q 来自解码器上一层,K 和 V 来自编码器最终输出。这是两个栈之间唯一的连接。它回答的问题是「我现在要生成这个词,源句里哪几个词相关」——这正是 2014 年 Bahdanau 注意力干的事,只不过现在它嵌在一个纯注意力的网络里,而不是给循环网络打下手。
三者的形状一致,语义不同。读论文时把这三处分清,图 1 就不会看乱。
前馈网络、残差、归一化与共享嵌入
每个编码器层里,除了注意力还有一层前馈网络。论文写得很短:
In addition to attention sub-layers, each of the layers in our encoder and decoder contains a fully connected feed-forward network, which is applied to each position separately and identically. This consists of two linear transformations with a ReLU activation in between. ... While the linear transformations are the same across different positions, they use different parameters from layer to layer. Another way of describing this is as two convolutions with kernel size 1. The dimensionality of input and output is d_model = 512, and the inner-layer has dimensionality dff = 2048.
Vaswani et al., §3.3
除注意力子层外,编码器与解码器中的每一层还包含一个全连接前馈网络,它对每个位置分别且相同地施加。它由两次线性变换构成,中间夹一个 ReLU 激活。……线性变换在不同位置上是相同的,但层与层之间使用不同参数。另一种描述方式是:两个卷积核大小为 1 的卷积。输入与输出的维度是 d_model=512,内层维度是 dff=2048。
FFN(x) = max(0, x W_1 + b_1) W_2 + b_2形状是 512 → 2048 → 512。「逐位置」意味着这层里没有任何跨位置的信息交换——所有跨位置的信息传递都由注意力完成。这是整个设计的分工:注意力负责「混合」,前馈负责「加工」。
算一下参数量,会得到一个反直觉的结论。每层多头注意力的参数是 4×512×512≈105 万(三个投影加 W^O)。每层前馈是 2×512×2048≈210 万。也就是说,前馈网络的参数是注意力的两倍,占每层参数的三分之二。很多人以为 Transformer 的参数主要在注意力上,其实恰恰相反。这一点在第十六节讲 MoE 时会再提一次——后来把模型做大,主要就是把这层前馈做宽。
残差连接和层归一化的作用,论文只用了半句话交代(见第三节引文),但它们不是配件。六层堆叠,梯度要从最后传到最前;残差给了一条直通的加法规避衰减,层归一化把每层输入的尺度稳住。少了任何一个,这个深度的纯注意力网络都训不动。
需要说明的是,论文用的顺序是 Post-LN:先加残差,再归一化。这个顺序在 2019 年前后被普遍改成 Pre-LN(先归一化,再过子层,最后加回残差),原因是 Post-LN 在层数多时梯度不稳定,要靠学习率预热兜着。GPT-2 之后的主流模型基本都是 Pre-LN 或其变体。这不是论文的错,是九年里被实践改掉的一处细节。
位置编码
自注意力有一个天生的缺陷:它对输入的顺序一无所知。把句子里的词打乱重排,注意力算出来的结果只是跟着换了位置,没有任何「先后」的信息。卷积有局部窗口,循环有先后状态,注意力什么都没有——它是一个集合运算。
论文的处理是显式地把位置信息加进输入:
Since our model contains no recurrence and no convolution, in order for the model to make use of the order of the sequence, we must inject some information about the relative or absolute position of the tokens in the sequence. To this end, we add “positional encodings” to the input embeddings at the bottoms of the encoder and decoder stacks.
Vaswani et al., §3.5
由于我们的模型既不含循环也不含卷积,为了让模型能利用序列的顺序,我们必须注入一些关于词元相对或绝对位置的信息。为此,我们在编码器与解码器栈的底部,把「位置编码」加到输入嵌入上。
用的是正弦与余弦:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
pos 是位置,i 是维度下标。偶数维用 sin,奇数维用 cos,波长从 2π 一路排到 10000·2π,越往后的维度波长越长。整个编码没有可训练参数,纯靠公式算出来。
为什么要用三角函数而不是直接写 0,1,2,3…?论文给的理由只有一句,但很关键:
We chose this function because we hypothesized it would allow the model to easily learn to attend by relative positions, since for any fixed offset k, PE(pos+k) can be represented as a linear function of PE(pos).
Vaswani et al., §3.5
我们选择这个函数,是因为我们假设它能让模型容易地学会按相对位置来注意,因为对任何固定的偏移 k,PE(pos+k) 都可以表示为 PE(pos) 的线性函数。
这句话背后的数学是:sin(α+β) 和 cos(α+β) 可以由 sin α、cos α 经一个旋转矩阵线性组合得到。所以「往前第 3 个位置」这个关系,在任意位置上的表示形式都是一样的——模型学一套偏移,就能全句通用,不必为每个绝对位置单独记。
理论上很优雅。实际效果呢?论文自己做了对照实验,把位置编码换成可学习的位置嵌入,结果:
We also experimented with using learned positional embeddings instead, and found that the two versions produced nearly identical results. We chose the sinusoidal version because it may allow the model to extrapolate to sequence lengths longer than the ones encountered during training.
Vaswani et al., §3.5
我们也试过改用可学习的位置嵌入,发现两个版本的结果几乎完全相同。我们选择正弦版本,是因为它可能让模型外推到比训练时更长的序列。
数字是 25.7 对 25.8(见第十二节的表 3 第 E 行),差 0.1 BLEU,在单次实验的噪声范围内。所以「正弦更好」这个印象是错的——论文选它的理由是可外推的可能性,不是实测优势。而且后来的实践表明,正弦编码的外推能力也远没有想象中好;真正解决长序列位置问题的是 2021 年的旋转位置编码(RoPE)和 ALiBi,那是第十六节的事。
为什么是自注意力:那张复杂度表
第 4 节是全篇最有说服力的部分。作者没有停在「我们的效果好」,而是给出一个结构性的论证:把自注意力、循环、卷积摆在一处比。
先看他们选的三条标准:
Motivating our use of self-attention we consider three desiderata. One is the total computational complexity per layer. Another is the amount of computation that can be parallelized, as measured by the minimum number of sequential operations required. The third is the path length between long-range dependencies in the network. Learning long-range dependencies is a key challenge in many sequence transduction tasks.
Vaswani et al., §4
促使我们使用自注意力,我们考虑三项要求。一是每层的总计算复杂度。二是可并行的计算量,用所需的最少顺序操作数来衡量。三是网络中长程依赖之间的路径长度。学习长程依赖是许多序列转换任务的关键挑战。
第三条是最容易被忽略、也最重要的一条。路径长度决定梯度要走多少步才能把信号从一端传到另一端:路径越长,越容易在传的过程中衰减、也越难学到。列在这里(论文 Table 1):
自注意力 每层复杂度:O(n²·d),顺序操作数:O(1),最大路径长度:O(1);循环 每层复杂度:O(n·d²),顺序操作数:O(n),最大路径长度:O(n);卷积 每层复杂度:O(k·n·d²),顺序操作数:O(1),最大路径长度:O(log_k n);受限自注意力 每层复杂度:O(r·n·d),顺序操作数:O(1),最大路径长度:O(n/r)。
n 是序列长度,d 是表示维度,k 是卷积核大小,r 是邻域大小。
读这几行要看三栏各自的含义。
顺序操作数:自注意力和卷积都是 O(1)——整层一次算完,不依赖前一步;循环是 O(n),必须一步步走。这一列直接对应「能不能用满 GPU」。
最大路径长度:自注意力是 O(1),任意两个位置在同一层内直接相连,不管隔多远;循环是 O(n),隔得越远步数越多;卷积是 O(log_k n),靠堆叠把感受野扩到远处。
每层复杂度:这是自注意力唯一吃亏的一列,O(n²·d) 里有个平方。序列一长,这一项会爆炸。
论文没有回避这一项,而是给了一个条件判断:
As noted in Table 1, a self-attention layer connects all positions with a constant number of sequentially executed operations, whereas a recurrent layer requires O(n) sequential operations. In terms of computational complexity, self-attention layers are faster than recurrent layers when the sequence length n is smaller than the representation dimensionality d, which is most often the case with sentence representations used by state-of-the-art models in machine translations.
Vaswani et al., §4
如表 1 所示,自注意力层用常数个顺序执行的操作连接所有位置,而循环层需要 O(n) 个顺序操作。就计算复杂度而言,当序列长度 n 小于表示维度 d 时,自注意力层比循环层更快,而在最先进机器翻译模型所用的句子表示中,这通常成立。
这句话的适用范围要读清楚:它成立的前提是 n < d。base 模型 d=512,句子长度几百个子词,条件成立。但如果序列长到几万(后来的长文档、图像、音频),n² 就压不住了。论文自己也意识到这点,在同一节末尾提出受限自注意力:每个位置只看周围 r 个邻居,复杂度降到 O(r·n·d),路径长度变成 O(n/r):
To improve computational performance for tasks involving very long sequences, self-attention could be restricted to considering only a neighborhood of size r in the input sequence centered around the respective output position.
Vaswani et al., §4
为提升涉及极长序列的任务的计算性能,可以把自注意力限制为只考虑输入序列中以各自输出位置为中心、大小为 r 的邻域。
这个提议当时没有做实验,只是一句话。但它预言了之后五年的一个研究方向:Longformer、BigBird、稀疏注意力,都是在这句话上长出来的。
最后,第 4 节收在一个附加好处上:
As side benefit, self-attention could yield more interpretable models. We inspect attention distributions from our models and present and discuss examples in the appendix. Not only do individual attention heads clearly learn to perform different tasks, many appear to exhibit behavior related to the syntactic and semantic structure of the sentences.
Vaswani et al., §4
作为附带好处,自注意力可能产生更可解释的模型。我们检查了模型的注意力分布,并在附录中给出并讨论例子。不仅单个注意力头明显学会了执行不同任务,许多头还表现出与句子句法和语义结构相关的行为。
注意用词是“could”和“appear to”,不是「证明」。这个谨慎是对的——第十四节会讲,后来有人专门写论文反驳「注意力权重就是解释」。
怎么训的
第 5 节全是工程细节,但这些细节决定了论文能不能被复现。逐项抄下来。
数据。 英德用 WMT 2014,约 450 万句对,byte-pair 编码,源和目标共享约 37000 的词表。英法用 WMT 2014,3600 万句,word-piece 编码,词表 32000。每个批大约包含 25000 个源语言词元和 25000 个目标语言词元,按近似长度把句子配成批,减少填充。
硬件与时间。 八块 NVIDIA P100。base 模型每步 0.4 秒,训练 10 万步,约 12 小时。big 模型每步 1.0 秒,30 万步,3.5 天。
优化器。 Adam,β1=0.9,β2=0.98,ε=1e-9。注意 β2 用的是 0.98 而不是默认的 0.999——这是在稀疏梯度场景下的常见调整,让二阶矩估计跟得更紧。
学习率不是固定的,按步数算:
lrate = d_model^(-0.5) · min(step^(-0.5), step · warmup_steps^(-1.5))This corresponds to increasing the learning rate linearly for the first warmup_steps training steps, and decreasing it thereafter proportionally to the inverse square root of the step number. We used warmup_steps = 4000.
Vaswani et al., §5.3
这相当于在前 warmup_steps 个训练步内线性增大学习率,之后按步数的平方根倒数成比例减小。我们取 warmup_steps=4000。
也就是先线性升到峰值,再按 1/√step 衰减。前 4000 步什么都不干,只用来把学习率抬上去。
为什么要预热?论文没解释,但这个设计后来被反复验证是必要的。一个合理的解释是:Adam 的二阶矩估计是从零开始累积的,最初几百步里这个估计非常不准,若此时学习率就很大,参数会被不准确的更新推得很远,且很难拉回来;先小步走一段,让统计量稳定,再加速。这个解释是我的推断,不是论文原话,但和后来关于 Pre-LN 稳定性的分析是吻合的。
正则化。 三样。残差 dropout 0.1,施加在每个子层输出加回残差之前,以及嵌入与位置编码相加之后。标签平滑 ε=0.1。论文对标签平滑的评价很实在:
During training, we employed label smoothing of value εls=0.1. This hurts perplexity, as the model learns to be more unsure, but improves accuracy and BLEU score.
Vaswani et al., §5.4
训练中我们采用值为 0.1 的标签平滑。这会损害困惑度,因为模型学会变得更不确定,但提升了准确率和 BLEU 分数。
指标之间会打架,这种如实报告在论文里不多见。
推理。 base 模型平均最后 5 个检查点的参数,big 平均 20 个。beam search 宽度 4,长度惩罚 α=0.6,最大输出长度取输入长度加 50。检查点平均是个便宜的集成手段,几乎不增加推理成本。
结果
Table 2 是全篇的核心证据。完整抄录:
ByteNet 英德 BLEU:23.75;Deep-Att + PosUnk 英法 BLEU:39.2,英法 训练算力(FLOPs):1.0×10²⁰;GNMT + RL 英德 BLEU:24.6,英法 BLEU:39.92,英德 训练算力(FLOPs):2.3×10¹⁹,英法 训练算力(FLOPs):1.4×10²⁰。
ConvS2S 英德 BLEU:25.16,英法 BLEU:40.46,英德 训练算力(FLOPs):9.6×10¹⁸,英法 训练算力(FLOPs):1.5×10²⁰;MoE 英德 BLEU:26.03,英法 BLEU:40.56,英德 训练算力(FLOPs):2.0×10¹⁹,英法 训练算力(FLOPs):1.2×10²⁰。
GNMT + RL(集成) 英德 BLEU:26.30,英法 BLEU:41.16,英德 训练算力(FLOPs):1.8×10²⁰,英法 训练算力(FLOPs):1.1×10²¹;ConvS2S(集成) 英德 BLEU:26.36,英法 BLEU:41.29,英德 训练算力(FLOPs):7.7×10¹⁹,英法 训练算力(FLOPs):1.2×10²¹。
Transformer(base) 英德 BLEU:27.3,英法 BLEU:38.1,英德 训练算力(FLOPs):3.3×10¹⁸;Transformer(big) 英德 BLEU:28.4,英法 BLEU:41.8,英德 训练算力(FLOPs):2.3×10¹⁹。
看这几行有三个角度。
第一,英德这一列,base 模型 27.3,已经超过所有此前的单模型和集成模型(最高 26.36)。big 模型 28.4,比历史最好成绩高 2 BLEU 以上。BLEU 上 2 分是很大的差距,通常一个模型迭代能涨 0.5 就算显著。
第二,算力这一列,base 只用 3.3×10¹⁸ FLOPs,是 ConvS2S 的三分之一、GNMT 集成版的五十分之一。用五分之一的算力拿到更高的分数,这才是「显著更省」的实证。
第三,英法这一列有个反常:base 只有 38.1,比 GNMT+RL 的 39.92 低。原因是 base 模型在英法上训练不足——论文只训练了 10 万步,而英法数据有 3600 万句,远多于英德的 450 万。big 模型训练更久,追到 41.8,创下单模型最好成绩。这个细节常被引用者忽略,但它说明「结构更好」和「训练充分」是两件事。
论文的表述是:
On the WMT 2014 English-to-German translation task, the big transformer model outperforms the best previously reported models (including ensembles) by more than 2.0 BLEU, establishing a new state-of-the-art BLEU score of 28.4. ... Training took 3.5 days on 8 P100 GPUs. Even our base model surpasses all previously published models and ensembles, at a fraction of the training cost of any of the competitive models.
Vaswani et al., §6.1
在 WMT 2014 英德翻译任务上,big 版 Transformer 超过此前报告的最好模型(含集成)2.0 BLEU 以上,确立 28.4 的新最好成绩。……在 8 块 P100 GPU 上训练耗时 3.5 天。即使我们的 base 模型也超过了所有已发表的模型与集成,而训练成本只是任何竞争模型的一小部分。
消融实验
第 6.2 节用一张表回答「哪些部件真的有用」。这是判断一篇架构论文是否扎实的关键——只报最好成绩不够,得说明每一处设计各值多少。
Table 3 的行很多,挑关键的说。基准是 base 模型在英德开发集(newstest2013)上的 25.8 BLEU。
base(6 层,512 维,8 头,64 维头) BLEU:25.8;单头(h=1,头维 512) BLEU:24.9,变化:−0.9;4 头 BLEU:25.5,变化:−0.3;16 头 BLEU:25.8,变化:0;32 头(头维 16) BLEU:25.4,变化:−0.4;头维 d_k 降到 16 BLEU:25.1,变化:−0.7。
头维 d_k 降到 32 BLEU:25.4,变化:−0.4;层数减到 2 BLEU:23.7,变化:−2.1;层数加到 8 BLEU:25.5,变化:−0.3;模型维度降到 256 BLEU:24.5,变化:−1.3;模型维度加到 1024 BLEU:26.0,变化:+0.2;前馈内层降到 1024 BLEU:25.4,变化:−0.4。
前馈内层升到 4096 BLEU:26.2,变化:+0.4;dropout 去掉 BLEU:24.6,变化:−1.2;dropout 升到 0.2 BLEU:25.5,变化:−0.3;位置编码改成可学习 BLEU:25.7,变化:−0.1。
读这几行能读出几件事。
层数影响最大。 从 6 层砍到 2 层,掉 2.1 BLEU,是全表最大跌幅。加深比加宽更值,但 6 层加到 8 层只涨 0.1 反而略降(25.5 vs 25.8)——说明 6 层在这个数据规模上已经接近饱和,再加层会过拟合。
单头确实不行,但不是越多越好。 h=1 掉 0.9,验证了多头不是为了凑数。可 32 头(每个头只剩 16 维)也掉 0.4,因为头太窄,每个头能表达的东西太少。论文的结论是:
While single-head attention is 0.9 BLEU worse than the best setting, quality also drops off with too many heads. In Table 3 rows (B), we observe that reducing the attention key size dk hurts model quality. This suggests that determining compatibility is not easy and that a more sophisticated compatibility function than dot product may be beneficial.
Vaswani et al., §6.2
单头注意力比最佳设置差 0.9 BLEU,但头太多时质量也会下降。在表 3 的 (B) 行我们观察到,减小注意力键的维度 dk 会损害模型质量。这说明判定相关性并不容易,也许比点积更精细的相关性函数会有帮助。
最后那句是个自我批评,也是伏笔——后来的工作确实在改进相关性函数,但主流方向不是换函数,而是加位置旋转(RoPE)。
dropout 很重要。 去掉掉 1.2 BLEU,是全表第二大跌幅。说明这个模型在这个数据量上过拟合明显。
瓦片(table 3 的完整版) 收在下面,需要逐行核对时可以打开。
附记:Table 3 完整消融表
div style="padding:0 0 20px">base:层数 N 6,d_model 512,d_ff 2048,h 8,d_k 与 d_v 各 64,P_drop 0.1,ε_ls 0.1,PPL 4.92,BLEU 25.8,65M 参数。
(A) 改动头数:h=1 时 d_k、d_v 各 512,PPL 5.29,BLEU 24.9;h=4 时各 128,PPL 5.00,BLEU 25.5;h=16 时各 32,PPL 4.91,BLEU 25.8;h=32 时各 16,PPL 5.01,BLEU 25.4。
(B) 缩头维:d_k 取 16 时 PPL 5.16,BLEU 25.1,58M;d_k 取 32 时 PPL 5.01,BLEU 25.4,60M。
(C) 改层数:N=2 时 PPL 6.11,BLEU 23.7,36M;N=4 时 PPL 5.19,BLEU 25.3,50M;N=8 时 PPL 4.88,BLEU 25.5,80M。改宽度:d_model 256、d_k 与 d_v 各 32 时 PPL 5.75,BLEU 24.5,28M;d_model 1024、各 128 时 PPL 4.66,BLEU 26.0,168M。改前馈:d_ff 1024 时 PPL 5.12,BLEU 25.4,53M;d_ff 4096 时 PPL 4.75,BLEU 26.2,90M。
(D) 改正则:P_drop 0.0 时 PPL 5.77,BLEU 24.6;P_drop 0.2 时 PPL 4.95,BLEU 25.5;ε_ls 0.0 时 PPL 4.67,BLEU 25.3;ε_ls 0.2 时 PPL 5.47,BLEU 25.7。
(E) 位置编码改用可学习嵌入:PPL 4.92,BLEU 25.7。
big:N 6,d_model 1024,d_ff 4096,h 16,P_drop 0.3,PPL 4.33,BLEU 26.4,213M 参数。
有一件事论文没做,需要指出:这一组里每个配置只跑了一次,没有报告多次随机种子的方差。差 0.1 到 0.3 的行(比如 16 头和 8 头同为 25.8,8 层 25.5 低于 6 层 25.8)在这种条件下无法判定是不是噪声。掉 2.1 和 1.2 的行没有这个问题,差 0.1 的行要打折看。
换个任务:句法分析
如果只在翻译上赢,可以解释说「这个结构适合翻译」。第 6.3 节做了另一件事:拿它去做英语成分句法分析,一个和翻译很不一样的任务——输入一句英语,输出一棵语法树。
用的模型更小:4 层,d_model=1024。结果:
Vinyals & Kaiser et al. (2014) 训练方式:仅 WSJ,判别式,WSJ 23 F1:88.3;Petrov et al. (2006) 训练方式:仅 WSJ,判别式,WSJ 23 F1:90.4;Zhu et al. (2013) 训练方式:仅 WSJ,判别式,WSJ 23 F1:90.4。
Dyer et al. (2016) 训练方式:仅 WSJ,判别式,WSJ 23 F1:91.7;Transformer(4 层) 训练方式:仅 WSJ,判别式,WSJ 23 F1:91.3;McClosky et al. (2006) 训练方式:半监督,WSJ 23 F1:92.1。
Vinyals & Kaiser et al. (2014) 训练方式:半监督,WSJ 23 F1:92.1;Transformer(4 层) 训练方式:半监督,WSJ 23 F1:92.7;Luong et al. (2015) 训练方式:多任务,WSJ 23 F1:93.0;Dyer et al. (2016) 训练方式:生成式,WSJ 23 F1:93.3。
只用 4 万句 WSJ 训练集时,91.3 略低于 Dyer 的 91.7;加上半监督数据后 92.7,超过 BerkeleyParser 的 92.1。
这个结果的意义不在分数,而在证明这个结构不是翻译专用的。论文没有为句法分析改任何超结构——只是换了个输出层,把树结构线性化成一串括号标记。这一点后来被推到极致:同一个结构换输出头就能做分类、生成、检索、甚至图像,这正是它成为通用骨架的原因。
三张注意力图
附录里放了三张注意力权重可视化。它们的价值不在于好看,而在于让「多头分工」这件事变得可见。
第一张来自编码器第 5 层的多个头,输入是一句话,讲 2009 年欧洲议会选举。焦点词是 making。

第二张和第三张是同一层(第 5 层)的两个头,处理代词指代。句子是 The Law will never be perfect, but its application should be just。焦点是 its——它指的是 the Law,中间隔了五个词。

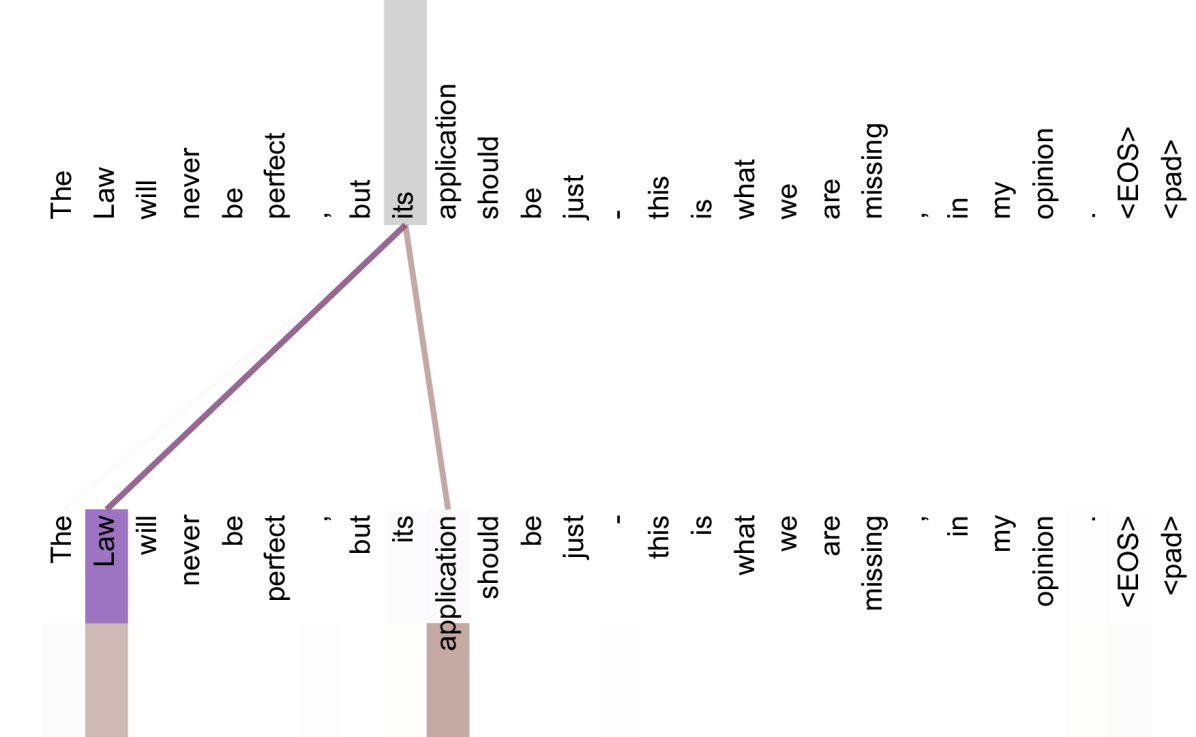
第四张是另一个头,展示的是句法结构层面的模式:动词和它的宾语、介词和它的宾语之间的权重更重。

三张图很有意思,但读的时候要保留三点怀疑。
第一,这是从 6 层 × 8 头 = 48 个头里挑出来的几个。论文没说挑了多少、依据什么挑。挑出来的头好看,不等于所有头都这样,也不等于这个模型整体上「懂了语法」。
第二,注意力权重高,只说明这个位置在这一次加权平均里占比大。它不等于因果——把这个权重改掉,输出未必变。2019 年 Jain 和 Wallace 的《Attention is not Explanation》就是拿这条做文章:他们给出一批反例,注意力分布完全不同、预测却相同;以及注意力相同、预测却不同。
第三,同年的《Attention is not not Explanation》又反驳回去,指出前一篇的实验设计有问题,在特定条件下注意力仍可作为解释。这场争论至今没有定论。
比较稳妥的结论是:注意力权重是一个有用的诊断信号,但不是模型推理过程的完整说明。论文自己用的词是 appear to,这个保留是恰当的。
论文自己承认的局限
好论文的标志之一是知道自己哪里不行。这篇论文在正文里散着承认了四处。
一、平方复杂度。 第九节引过,Table 1 里自注意力是 O(n²·d)。序列翻倍,计算量翻四倍。受限注意力的提议只写了一句话,没有实验。
二、生成仍然是顺序的。 训练可以全并行,但推理时还是要一个词一个词吐,因为第 t+1 个词依赖第 t 个。这一条到九年后的今天仍然成立,只是被 KV 缓存和投机采样缓解了一些。论文结论里直接写了这是下一步:
Making generation less sequential is another research goal of ours.
Vaswani et al., §7
让生成过程更少顺序性,是我们的另一个研究目标。
三、位置编码的外推只是可能。 第八节说过,选正弦版本的理由是「可能允许外推」,而实测与可学习版本几乎无差。论文没有验证外推到更长序列的效果。
四、没有在大规模上验证。 这篇论文的全部实验都在翻译和句法分析上,最大 213M 参数,最长的训练 3.5 天。它没有回答「如果把这个结构放大一千倍会怎样」。这个问题的答案在四年后才出来,而且是别人给的。
这四条局限里,前三条论文自己写了,第四条是我补的——站在九年之后看,它是这篇论文留下的最大空白,也是最值钱的那块空白。
九年之后回看
到 2026 年,这篇论文的原始形态几乎处处被改过,但核心没动。按改动的位置分五类。
归一化的位置换了。 论文用 Post-LN。2020 年前后的分析指出,Post-LN 在深层的梯度尺度会随层数放大,必须靠 warmup 压住;改成 Pre-LN(先归一化再过子层)后训练稳定得多,甚至可以不预热。GPT-2 之后的主流模型基本都用 Pre-LN 及其变体(RMSNorm 之类)。图 1 里那两个 Add & Norm 的顺序,今天的模型大多反过来了。
位置编码换了。 正弦编码在长序列上表现不佳,因为它对超出训练长度的位置没有约束。2021 年苏剑林等人提出旋转位置编码(RoPE),把位置信息做成对 Q、K 的旋转,让注意力分数天然带上相对位置;同年 ALiBi 用给注意力分数加一个随距离递减的偏置。今天几乎所有开源大模型都用 RoPE 或它的变体。第八节那个 sin/cos 公式,现在主要出现在教科书里。
注意力本身被改了。 三个方向。一是减少计算量:Longformer 用滑动窗口加全局 token,BigBird 用稀疏模式,把 O(n²) 压到线性;Linformer、Performer 用低秩近似或核方法。二是减少推理时的显存:Multi-Query Attention(Shazeer,2019)让所有头共享一组 K、V,Grouped-Query Attention(2023)折中成几组,KV 缓存能省几倍。三是改实现不改数学:FlashAttention(2022)靠分块计算把注意力对显存的读写降到线性,数学上与论文完全等价,速度却快数倍。这是最像「工程胜利」的一类改进。
前馈层变成了混合专家。 第七节算过,参数的三分之二在前馈层。所以后来把模型做大,主要做法不是加深注意力,而是把前馈层拆成很多个专家、每次只激活其中几个(MoE)。有意思的是,这篇论文的参考文献 [32] 就是 Shazeer 同年那篇稀疏门控 MoE,作者当时已经在想这件事。
架构收敛到只用解码器。 论文是编码器—解码器结构,为翻译设计。后来的大语言模型几乎全部只用解码器那一半:去掉交叉注意力,只保留掩码自注意力加前馈。原因不是它效果更好,而是它更通用——任何任务都可以写成「给一段前缀,续写下去」,一个目标函数通吃。图 1 的左半边,在这条路线上被整个删掉了。
九年里参数从 65M 走到几千亿,涨了四个数量级;训练数据从 450 万句走到万亿 token。但把今天的模型和图 1 对照,剩下的共同点仍然是那一条:层与层之间唯一的跨位置信息通道是注意力。这一条没被改过,也不像会被改。
八个人
论文第一页底下有一条脚注,多数人翻过去不看。前半句是「贡献相同,署名顺序随机」,后半句六句,逐条写明谁做了什么。这条脚注是读这篇论文最好的入口,因为它自己承认了:这不是一个人的洞见。
Equal contribution. Listing order is random. Jakob proposed replacing RNNs with self-attention and started the effort to evaluate this idea. Ashish, with Illia, designed and implemented the first Transformer models and has been crucially involved in every aspect of this work. Noam proposed scaled dot-product attention, multi-head attention and the parameter-free position representation and became the other person involved in nearly every detail. Niki designed, implemented, tuned and evaluated countless model variants in our original codebase and tensor2tensor. Llion also experimented with novel model variants, was responsible for our initial codebase, and efficient inference and visualizations. Lukasz and Aidan spent countless long days designing various parts of and implementing tensor2tensor, replacing our earlier codebase, greatly improving results and massively accelerating our research.
Vaswani et al., 首页脚注
贡献相同,署名顺序随机。Jakob 提出用自注意力替换 RNN,并启动了对这个想法的评估。Ashish 与 Illia 设计并实现了最早的 Transformer 模型,几乎参与了这项工作的每一个方面。Noam 提出了缩放点积注意力、多头注意力与无参数的位置表示,也是另一个几乎参与每个细节的人。Niki 在我们最初的代码库和 tensor2tensor 里设计、实现、调参并评估了无数模型变体。Llion 也试了新的模型变体,并负责最初的代码库、高效推理与可视化。Lukasz 和 Aidan 花了数不清的长日子设计并实现 tensor2tensor 的各个部分,替换掉我们更早的代码库,大幅改善了结果,也大幅加快了研究进度。
六句话里,有三件事值得单独说。
多头注意力是 Shazeer 提的。 脚注把「缩放点积注意力、多头注意力、无参数位置表示」三样一起算在他头上,这三样恰好是论文里被引用最多的三个技术点。位置编码那一节说过,他们试过可学习版本,效果几乎一样,所以「无参数」这个选择也记在他名下。网上讲这篇论文的文章,常把多头注意力说成集体成果,脚注不这么看。
想主意的人和写代码的人分得很清。 Kaiser 与 Gomez 那一条几乎全是工程:用 tensor2tensor 整套替换掉早期代码库。这件事听上去是杂活,但论文能出结果,一半靠结构,一半靠这套库把实验循环跑得足够快——第十二节那张十八行的消融表,就是这么试出来的。
Parmar 那一条最不显眼,也最实。 designed, implemented, tuned and evaluated countless model variants,十一个词。没有这十一个词,第十一节和第十二节的两张结果表都不存在。
八个人从哪来
按论文署名顺序,一个个说。
Ashish Vaswani,第一作者。印度出生,在印度和中东长大。本科在 Birla Institute of Technology, Mesra 读计算机工程,2004 年去南加州大学读研,2014 年博士论文做的是统计机器翻译,题目大意是「更小、更快、更准的统计机器翻译模型」,导师是 David Chiang 和 Liang Huang。读博期间他在南加大的信息科学研究所做神经语言模型。2012 年他去过一趟巴布亚新几内亚,参加用语言技术记录濒危语言的项目——那时候深度学习在自然语言处理里还是个不太被看好的方向。2016 年进 Google Brain。
Noam Shazeer,来路和其余七个都不一样。费城出生,高中时代表美国队参加 1994 年国际数学奥林匹克,拿了满分金牌。同年进杜克大学读数学与计算机,第一个学期就在 Putnam 数学竞赛里考了全国第六,之后带杜克队在 1996、1997 年拿过团体第一和第二。本科毕业后去伯克利读研,没读完。2000 年进 Google,当时公司只有两百人上下。他做的第一件大事是把搜索的拼写纠错重写了一遍,后来又写了 PHIL,那套按主题给网页分类的算法成了 AdSense 的内核。2009 年短暂离开过一次,2012 年被 Google Brain 吸引回来。
Niki Parmar,八个人里唯一的女性,也是当时团队里最年轻、唯一没有博士学位的一个。印度浦那出生,本科在浦那计算机技术学院读信息技术,期间靠在线课程接触机器学习。2013 年去南加州大学读计算机硕士,2015 年毕业进 Google。她与 Vaswani 就是在南加大认识的——Vaswani 回校讲过一次神经网络,两人后来成了长期搭档,一起创办过两家公司。
Jakob Uszkoreit,这件事的起点。德国人,父亲 Hans Uszkoreit 是计算语言学家,早年在斯坦福研究院做人工智能。他本人在柏林工业大学读计算机与数学,读博期间转去业界,2008 年进 Google。2014 年前后他起了个念头:语言能不能不按顺序读,一次看全句各词之间的关系。他管这叫自注意力。当时主流是 LSTM,这个想法等于要把现成的东西全扔掉,他父亲也不看好。2021 年他离开 Google,与斯坦福的计算生物化学家 Rhiju Das 创办 Inceptive,用深度学习设计 RNA 药物。
Llion Jones,威尔士人,出生在班戈,在班戈和阿伯吉诺尔温长大,母语是威尔士语。伯明翰大学读人工智能与计算机,本科加硕士,2009 年毕业。先去了一家做计算机辅助制造的公司 Delcam,2011 或 2012 年进 Google,在 YouTube 做工程,2015 年转到研究岗。论文那个标题是他起的。2023 年他离开 Google,在东京与 David Ha 创办 Sakana AI。2025 年他说过一句被反复引的话:他对 transformer 已经「烦透了」。
Aidan Gomez,八个人里最小的。加拿大安大略省 Brighton 小镇长大,多伦多大学读计算机与数学。2017 年他在 Google Brain 多伦多办公室实习,二十岁,本科还没毕业,论文里 tensor2tensor 那部分是他和 Kaiser 一起做的。他后来去牛津读博,读到一半停下来创业,2024 年才把学位拿到。2019 年他与 Ivan Zhang、Nick Frosst 创办 Cohere,做企业向的模型服务,不去挤消费级聊天机器人。
Łukasz Kaiser,纯理论出身。波兰人,弗罗茨瓦夫大学数学与计算机双硕士,2008 年在亚琛工业大学拿博士,做的是逻辑与自动机理论,和神经网络没有关系。之后他在巴黎狄德罗大学和法国国家科研中心有终身职位。2013 年他把终身职位辞了,去 Google Brain。他写 TensorFlow,也写 tensor2tensor。2021 年去 OpenAI,后来是 GPT-4 长上下文的负责人。
Illia Polosukhin,那个把想法变成项目的人。乌克兰哈尔科夫出生,哈尔科夫国立大学应用数学与计算机硕士,2014 年进 Google Research,做的是搜索的即时问答——让问题直接在结果页上有答案,那是 2012 年为了应对 Siri 启动的项目。他在那儿撞上性能瓶颈,Uszkoreit 把自注意力的想法讲给他,他接了下来,又拉来 Vaswani。2017 年初他先离开 Google,后来创办 NEAR。
把这八条并排放,会看到一个不太像「天团」的组合:三个大洲,七个国家,来路分别是理论逻辑、搜索引擎广告、机器翻译、YouTube 工程,以及一个本科实习生。当时有博士学位的只有两个人——Kaiser 2008 年、Vaswani 2014 年,其余六个要么硕士、要么博士没读完。这个构成解释了论文的语气:它不是权威在宣布结论,是几个工程师在报告一次实验做得怎么样,包括哪儿没做好。
这支队伍是怎么凑起来的
2016 年 Uszkoreit 拉人做了个小规模实验,证明自注意力有点东西。但一起做的人做完就去忙产品了,用他的说法,像是赌场里小赢一把就走的人。他不甘心。
后来他在 Google 食堂碰到 Polosukhin,把想法讲了一遍。Polosukhin 正被搜索问答的性能卡着,听完就接了,并把 Vaswani 拉了进来。三个人写了一份设计文档,把名字定为 Transformer。2017 年初 Polosukhin 离职去创业,Parmar、Jones、Kaiser 和实习生 Gomez 陆续补进来,八个人才凑齐。
据 2024 年 GTC 那场对谈上提到的说法,在那之前,这八个人没有同时待在一个房间里过。一篇改了整个领域的论文,是一群分散在不同办公室、多数时候靠远程协作的人写出来的。
后来八个人陆续都离开了 Google。Gomez 做了 Cohere;Shazeer 创办 Character.AI,2024 年 Google 以约 27 亿美元的技术授权把他和团队请回去负责 Gemini,2026 年 6 月他又去了 OpenAI;Vaswani 与 Parmar 先后创办 Adept 与 Essential AI,Parmar 2024 年底转去 Anthropic,Vaswani 的 Essential AI 在 2026 年 6 月被英伟达收进;Uszkoreit 做生物方向的 Inceptive;Jones 在东京办 Sakana AI;Kaiser 也在 OpenAI;Polosukhin 去做 NEAR。到 2026 年,八个人散在七家机构,其中 Shazeer 和 Kaiser 又碰在了同一家。
标题,和一次判断失误
标题不是学术推导出来的。据 Llion Jones 后来在多次访谈里说,是交稿前两天想到的,致敬 Beatles 的《All You Need Is Love》,他说只花了五秒钟,也没想到大家真会这么叫。Transformer 这个名字是 Jakob Uszkoreit 选的,理由是他喜欢这个词的发音。
有一个反差值得记下:这个结构是 Google 提出来的,但把它推到产品级、推到 ChatGPT 的,是 OpenAI。论文发表时 Google 内部对它的定位是「一个更好的翻译模型」,而不是「下一代计算的底座」。判断失误不在技术,在想象力——这一点比论文里任何一张表都更值得读。
怎么读这篇论文
如果只有两小时,建议这个顺序:
先看 Figure 1 和 Table 1。前者告诉你结构,后者告诉你作者为什么认为这个结构更好。这两张图撑起了全文 80% 的论证。
再读 3.2.1 和 3.2.2 两小节,加起来不到一页,注意力机制的公式和它为什么这么写都在里面。
然后直接跳到第 6 节看结果和消融。第 5 节的训练细节可以留到要复现的时候再看。
第 4 节的复杂度分析值得单独读一遍,它是全篇最像「论证」而不是「报告」的部分。
最后读结论的最后一段,作者在那里承认了三个没解决的问题,比正文更有信息量。
四段视频,按需要选:
参考
- Attention Is All You Need(arXiv 摘要页) · 原文
- 论文 PDF 原文 · 原文
- 论文 HTML 版(图与公式可单独打开) · 原文
- Neural Machine Translation by Jointly Learning to Align and Translate(Bahdanau et al., 2014) · 前作
- Convolutional Sequence to Sequence Learning(Gehring et al., 2017) · 对照
- Neural Machine Translation in Linear Time(ByteNet, 2016) · 对照
- Attention is not Explanation(Jain & Wallace, 2019) · 讨论
- Attention is not not Explanation(Wiegreffe & Pinter, 2019) · 讨论
- On Layer Normalization in the Transformer Architecture(Xiong et al., 2020) · 后续
- RoFormer: Enhanced Transformer with Rotary Position Embedding(Su et al., 2021) · 后续
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(Dao et al., 2022) · 后续
- Fast Transformer Decoding: One Write-Head is All You Need(Shazeer, 2019) · 后续
- tensor2tensor(论文官方代码库) · 代码